Golang基础(五):goroutine并发哲学、原理实现与编程
并发编程
golang并发哲学
同C++/java等传统语言不一样,golang天生支持并发,而且使用的设计哲学是通信顺序进程(Communicating sequential processes, CSP);
并发与并行
golang严格区分了并发和并行的含义:
并发(Concurrency):解决多个任务如何合理地组织起来,例如单核情况下不同任务的时间片分配;(核内依赖于时间片调度);
并行(Parallelism): 解决如何在多核上同时跑更多东西,例如多核情况同时进行多个任务(核间本身不依赖时间片并发);
将问题拆分成多个可独立推行的任务,至于任务的调度、是否多核同时进行,完全由golang运行调度器决定。
通信顺序进程CSP
我们知道,C++/java的并发完全依赖于对共享内存的控制,每个想访问共享内存的线程都需要先获取锁,才能对内存进行读写;尽管存在一些被称为无锁编程的事务,例如原子变量,实际上是来自底层硬件CAS的支持,而且复杂的对象结构仍然会退化成自旋锁或者互斥锁的机制。
1978年,Tony Hoare(1980图灵奖得主,于26年3月15日逝世,享年92岁)提出了CSP模型并指出其本质不是一种进程演算,而是一种并发编程语言,进程或者线程间通过通信来协调进程或者线程间通信,这种通信媒介是通过通道进行的,进程内各种状态只能通过通道暴露,如果通道缓存区满,发送方阻塞直至缓冲区重新就绪。
依赖于CSP模型,golang的设计却走上一条截然不同的路:
Do not communicate by sharing memory, instead, share memory by communicating.(不要通过共享内存来通信,而是要通过通信来实现共享内存);
golang的并发对象是比线程更加轻量化的goroutine,简单而言:
golang的共享内存被单个goroutine拥有,其他goroutine想要修改共享内存,唯一做的事情就是带着指令在那个goroutine排队;
做个类似的比喻:过去如同C++等实现并发,就像很多人要进入饭店吃饭,需要等接待员叫,被叫到的人(获取锁)的人允许吃饭,但是有很多问题:
接待员可能是近视眼,程序不做负载均衡,有的人可能永远不会被叫到,也不会严格遵循FIFO;(线程被饿死)
饭吃完了,但是在吹牛忘记要走了,外面的人进不来;(任务完成,忘记释放锁导致死锁)
能进去吃饭,可能点菜、上厕所也需要额外授权,且要和其他客人配合默契,否则上洗手间的客人等你点完菜找服务员,你在等客人的洗手间;(内含嵌套、递归锁,解锁没有按逆序释放,存有潜在的死锁)
考虑点什么菜,打什么包;(锁的颗粒度自行控制,耗费心智和麻烦);
每张桌子都要关联一个服务员,切换服务员要重新建立一次点菜上下文信息;(获取锁的对象是线程,线程上下文切换开销较大);
当然,在C++中设计合理的程序,上述若干问题是能够被解决或者优化的,取决于设计者水平和能够触碰的业务边界;但基于CSP模型,上述问题都在golang中得到较为妥善的解决。一般而言,go建议使用CSP并发,但处于对mutex的尊重,其sync包也提供了基于锁的Mutex实现。
goroutine
goroutine是golang实现的轻量化的线程,也可以认为是一种协程,它们的英文和类似:goroutine和coroutine,只是不如Java和C++那样使用await和yeild一样典型,它在若干个方面比系统创建的线程要优越:
栈占用小:os线程习惯一次性创建MB级别的栈,而goroutine初始栈只有几个KB(典型值为2KB),并且根据调用栈动态增长(甚至最大能到1G,极少用到)和缩减;
可获取并发资源更多: 同样的机器可能只能有几百上千的软件线程,但可以多开甚至几十万条goroutine;
创建、销毁、切换成本极低:线程的创建需要调用系统api,切换内核态和用户态,而golang只需要用户态级别的备份和恢复,近似函数调用;
不阻塞真实线程:goroutine是基于线程的抽象,阻塞goroutine时可以不必阻塞os线程,让os线程继续执行其他goroutine;
因为goroutine是go并发中唯一的对象原语,因此本文采用协程作为goroutine的中文简称;
goroutine Demo
在golang中使用goroutine非常简单,在调用普通函数或者匿名函数时,直接用go关键字即可,这样任务会在goroutine上运行:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
package main
import (
"fmt"
"time"
)
func main() {
go func() {
fmt.Println("This is goroutine task")
}()
fmt.Println("This is main thread!")
time.Sleep(10 * time.Millisecond)
}
所有协程都会在主协程中启动和退出,故主协程退出,其余协程也会退出。除此以外,其余一切方式创建的协程,都没有父子和隶属的概念,它们都是并行的,尽管你在一个goroutine中启动另一个goroutine:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
package main
import (
"fmt"
"time"
)
func son() {
fmt.Println("This is son func")
}
func main() {
go func() {
go son()
fmt.Println("This is goroutine task")
}()
fmt.Println("This is main thread!")
time.Sleep(10 * time.Millisecond)
}
sync.WaitGroup
使用延时等待任务退出在生产环境是不能接受的,golang的sync包提供了sync.WaitGroup可以用于等待任务退出,基本使用为:
1
2
3
4
5
6
7wg.Add(1) //添加要等待的协程数
go func() {
defer wg.Done() //退出前通知主协程就绪
// ... do somethings
}()
wg.Wait() //主协程等待1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18package main
import (
"fmt"
"sync"
)
func main() {
var wg sync.WaitGroup
wg.Add(1)
go func() {
defer wg.Done()
for i := range 20 {
fmt.Println("cnt: ", i)
}
}()
wg.Wait()
fmt.Println("This is main thread!")
}
WaitGroup相关异常
WaitGroup本质是一种计数器,add增加计数,done减少计数,计数器归零,wait退出阻塞。对于这种中规中矩的提前add,完成done,很容易遇到数目不匹配的异常,以下是相关现象:
add总数 > done总数:wait一直阻塞,go不会程序死等,会打印死锁信息:
1
2
3
4
5
6
7
8
9
10var wg sync.WaitGroup
wg.Add(2) //实际上只跑了一个goroutine
go func() {
defer wg.Done()
for i := range 20 {
fmt.Println("cnt: ", i)
}
}()
wg.Wait() //fatal error: all goroutines are asleep - deadlock!
fmt.Println("This is main thread!")add总数 < done总数:计数器变负数,会触发panic:
1
2
3
4
5
6
7
8
9
10
11
12
13var wg sync.WaitGroup
wg.Add(1) //实际上done了两次
go func() {
defer wg.Done()
defer wg.Done()
for i := range 20 {
fmt.Println("cnt: ", i)
}
wg.Done()
}()
wg.Wait() //panic: sync: negative WaitGroup counter
fmt.Println("This is main thread!")
也有可能不会panic,因为add的数量不对,wait不成功,有的goroutine不会执行!
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package main
import (
"fmt"
"sync"
)
func main() {
var wg sync.WaitGroup
wg.Add(1) //实际上跑了两个goroutine
go func() {
defer wg.Done()
for i := range 20 {
fmt.Println("cnt: ", i)
}
}()
go func() { //实际上没有wait成功,也不会执行这个;
defer wg.Done()
for i := range 20 {
fmt.Println("cnt: ", i)
}
}()
wg.Wait() //fatal error: all goroutines are asleep - deadlock!
fmt.Println("This is main thread!")
}
拓展:goroutine的任务调度
GPM模型
golang的协程调度使用了GPM模型,分别指Goroutine、Processor与Machine:
Goroutine: 启动的goroutine数目;Processor:并行度,一般而言是虚拟逻辑CPU数量,表示能调度的CPU资源,每个P能够绑定一个本地可运行队列(local runq),降低全局锁的竞争;Machine:操作系统的线程,真正运行go代码的底层,也是我们一般理解的线程,可能trap、syscall或者执行cgo;
GPM模型从go 1.1起开始引入P层,旨在解决GM模型全局锁竞争严重的问题,最大化利用机器的并发性能,其中的关键在于基于P层实现了工作窃取的调度器:详见调度器源码分析。
通过这种架构,创建M个线程(CPU调度的线程单位),N个goroutine都会依附在这M个线程上执行,而且当某个goroutine阻塞,runtime会将goroutine调度走,这就是goroutine调度的M:N模型。
goroutine入队与调度
goroutine存在两种执行队列:P的本地runq和全局的runq。一般而言,本地runq是一个环形数组(固定长度,典型值为256)以及一个支持插队执行的runnext槽;goroutine优先放入本地runq,因为同一个P锁的竞争较少、效率更高,当本地runq满,会将一半的goroutine放入全局队列让其他P调度;此外,本地runq队列支持原子CAS操作,以方便其他P来本地runq窃取任务;
goroutine的调度在schedule函数中进行,主要存在三种情况:
从本地P的runq队列中取出一个goroutine执行,首先搜索runnext,若存在高优先的g,首先执行,随后才搜索环形队头的g;
从全局的runq取出任务执行;为了兼顾性能和全局runq任务相对公平的调度,当
schedule函数被调用61次后才会尝试获取全局锁和搜索可运行的goroutine;从其他的P中窃取任务;窃取前会查看是否所有P处于空闲状态,然后查看是否有大量处于窃取状态的P,若是则取消窃取进入睡眠,否则当前P会进入自旋状态,并且多次(4次)按随机序扫描其他所有的P的runq任务,最后一次甚至会扫描其他P的runnext槽,等待执行
3us防止改runnext任务正在执行,随即将任务偷走,若其他P也无任务,会最后回顾全局队列是否有新任务,否则解除工作线程与P的绑定,P加入空闲P列表,M进入休眠状态直到被唤醒;
拓展: go程序初始化
不仅go程序,系统加载可执行文件大概都会经过以下阶段:
从磁盘读取可执行文件,加载到内存;
创建进程和主线程,为主线程分配栈空间;
把用户命令行参数拷贝到栈空间;
把主线程放入操作系统运行队列等待系统调度;
go程序elf入口位于_rt0_amd64_linux,windows系统对应go程序的入口是rt0_windows_amd64.s,要看到这个很简单,自己编一个go程序然后使用gdb即可。在windows下为linux交叉编译也非常简单,没有cgo情况下直接设置环境变量即可:
1
2
3
4
5
6
7
8
9
10
11
12#powershell
$env:GOOS="linux"
$env:GOARCH="amd64"
$env:CGO_ENABLED="0"
#windows cmd
set GOOS=linux
set GOARCH=amd64
set CGO_ENABLED=0
#然后禁用优化编译:
go build -gcflags "-N -l" -o helloTest .\main.go1
2gdb helloTest
info files0x47f7a0:
1
2b *0x47f7a0
rrt0_go汇编的核心任务主要是:
将启动参数
argc/argv从栈或者寄存器拷贝到临时寄存器或内存,保证后续runtime能访问;为
g0分配栈空间;建立runtime线程的TLS(线程本地存储),因为runtime必须在任意地方快速获取g,以便进行goroutine调度、抢占、检查等;在linux中,会读取
m0的tls成员地址,通过底层的runtime.settls设置TLS(本质是写入到fs段,获取时直接从fs段寄存器读取),随机runtime通过getg()就能够快速获取当前的g;绑定和初始化
m0和g0: m0与g0互相引用:g0.m=&m,m0.g0=&g0, setg(&g0), 即将g0设置在m0的tls槽,表示当前m0正在以g0作为goroutine运行;初始化
g0栈:g0栈是系统调度栈,空间不会像用户栈那样动态增减,初始时runtime会根据sp指针将g0对齐并推算栈顶g0.stack.hi和栈底g0.stack.lo,并且设置g0.stackguard0(用于正常检测栈溢出)和g0.stackguard1(用于抢占等特殊目的);
在Unix系统中,g0栈通常直接使用os线程初始分布的栈并且设置hi和lo和stackguard。至此,runtime就具备执行go代码的能力了,但rt0_go还没结束,接下来开始介绍如何构建用户栈:
- 初始化
m0:主要是为初始化调度器和创建goroutine创造环境,如将argc和argv拷贝到runtime全局,初始化CPU数量、随机种子、信号线程、time等,最重要的是执行调度器函数runtime.schedinit, 包含以下任务:- 内存分配器、堆初始化(page allocator);
- gc子系统关键结构初始化;
- 模块/符号信息初始化(用于panic或者反射)
- 初始化调度器初始状态
- 执行
mcommoninit,带锁检查m数量是否超出系统线程数目上限(如10000条),将m挂载到全局allm上,allm是一个全局循环链表,指向新插入的m的alllink字段,新alllink字段指向上一个m的alllink字段,效果如下: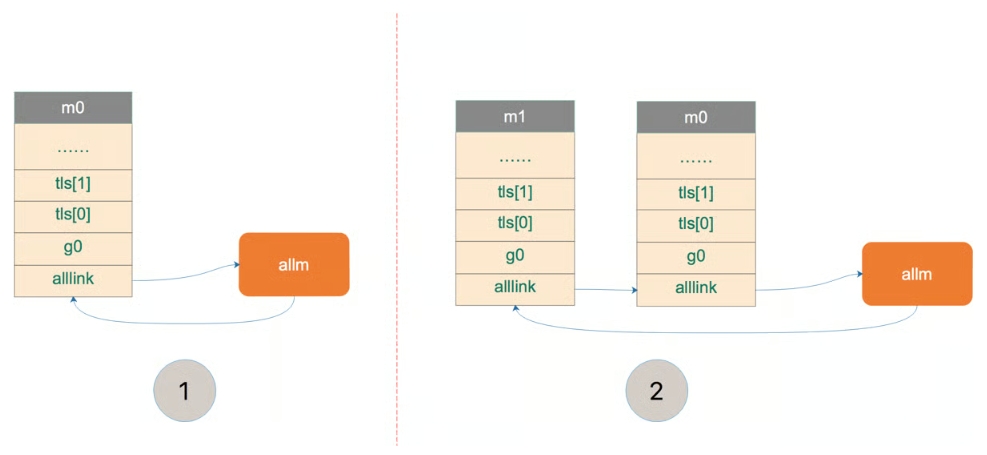
- 初始化
allp,构建p的管理结构:根据设置的GOMAXPROCS来决定P的数目nprocs(默认是设备虚拟cpu硬件线程数,如一般电脑为16,最大不超过1024),然后会一次性分配nprocs个P并分配空间,设置状态为_Pgcstop,若nprocs较前次减少会释放额外的P空间,绑定m0和p0,将p0标记为_Prunning;函数还会遍历所有的P,如果P对应的g全部没有处于running状态,那么P就是空闲的,这个P会被加入到空闲队列等待调度,并且设置状态为_Pidle;
至此,m0、g0、p0已经初始化完毕并且相互绑定,具备创建和调度goroutine的能力。如果程序需要更多的os线程,golang会首先在调度器sched.midle查找空闲的M,若无则通过allm新建新的m,绑定到协程g,并且从p空闲链表取出进行绑定。
最后就是调度第一条用户级的goroutine执行runtime.main函数,这也是关系rt0_go的最后的任务:
rt0_go准备参数环境,调用runtime.newproc(SB),这个函数会从gfree列表获取g并且分配用户栈(2KB起步,按需增长),设置上下文sp、pc和程序入口(此处是runtime.main),runtime.newproc还会接收两个参数,其一是获取函数地址fn,其二是参数大小siz,决定了新的g从原来系统调度栈g0拷贝多少字节的参数,随即设置g的状态为runnable并且放入runq等待被某个P或全局runq调度。用户态的新goroutine入队后,
rt0_go任务就完成了,但g0不会保持空闲,它会运行schedule()调度函数:即执行从1
2
3
4
5
6func schedule() {
for {
gp := findRunnable() // 从 P 本地队列/全局队列/网络轮询等找一个 runnable G
execute(gp) // 切换到 gp 的栈与上下文,开始运行它
}
}g0到新g的运行的切换,如:- 将当前
g0寄存器/PC/SP保存至g0.sched,恢复目标g的g.sched,更新m的tls为目标g,第一条用户态goroutine(也是主协程,main goroutine)开始运行,跳转至执行入口,对于此处,即跳转至runtime.main。
- 将当前
至此,rt0_go的基本流程就结束了,这也是go程序的初始化流程,后续runtime.main还有各种操作,如:启动sysmon、执行各包的init函数,调用主函数main.main、执行完主函数后的清理工作等;
runtime
runtime包提供了一些协程控制的底层能力,如主动让出goroutine占用、立刻终止goroutine等,也可以查看G、P等信息。
P一般等于虚拟硬件线程的数目,但并非严格关系,可以根据环境变量打印或者自定义设置:
1
2p := runtime.GOMAXPROCS(0)
fmt.Println(p, runtime.NumCPU()) // 16 16
可以通过设置P达到串行goroutine(但不保证顺序执行,好像除了限制并发没什么用):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23package main
import (
"fmt"
"runtime"
"sync"
)
func main() {
runtime.GOMAXPROCS(1)
var wg sync.WaitGroup
wg.Add(2)
go func() {
defer wg.Done()
fmt.Println("111111")
}()
go func() {
defer wg.Done()
fmt.Println("222222")
}()
wg.Wait()
}runtime.Gosched()会将g放回P的runq中,M从runnext或者runq取出下一个任务执行,此处如果限制P,则得到:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package main
import (
"fmt"
"runtime"
"time"
)
func main() {
runtime.GOMAXPROCS(1)
go func() {
for i := range 10 {
if i <= 5 {
fmt.Println("[goroutine 1a]", i)
runtime.Gosched() //去执行goroutine 2
}
fmt.Println("[goroutine 1b]", i)
}
}()
runtime.Gosched() //先执行goroutine1
go func() {
for i := range 10 {
defer func() {
fmt.Println("exit value: ", i)
}()
if i == 5 {
runtime.Goexit()
}
fmt.Println("[goroutine 2]", i)
}
}()
time.Sleep(10 * time.Millisecond)
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27[goroutine 1a] 0
[goroutine 2] 0
[goroutine 2] 1
[goroutine 2] 2
[goroutine 2] 3
[goroutine 2] 4
exit value: 5
exit value: 4
exit value: 3
exit value: 2
exit value: 1
exit value: 0
[goroutine 1b] 0
[goroutine 1a] 1
[goroutine 1b] 1
[goroutine 1a] 2
[goroutine 1b] 2
[goroutine 1a] 3
[goroutine 1b] 3
[goroutine 1a] 4
[goroutine 1b] 4
[goroutine 1a] 5
[goroutine 1b] 5
[goroutine 1b] 6
[goroutine 1b] 7
[goroutine 1b] 8
[goroutine 1b] 9func放入runnext,故有可能先进入g2,所以插入一个Gosched让给g1,
g1执行完一次就去执行g2了,然后在i==5时退出,触发defer,随即再继续执行0到9;
此外,runtime还提供Caller等支持查看调用者信息供给日志打印:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21package main
import (
"fmt"
"runtime"
)
// 实现函数名打印函数
func getRunTimeInfo() (pc uintptr, file string, line int, ok bool) {
return runtime.Caller(1) //1代表调用者,0代表当前函数,2代表调用者的调用者,以此类推
}
// 值传递
func log(x any) {
pc, file, line, _ := getRunTimeInfo()
fmt.Printf("[%s][line_%d][%s]:%#v\n", file, line, runtime.FuncForPC(pc).Name(), x)
}
func main() {
log("i am spider man") //[D:/Documents/Desktop/alphaGo/main.go][line_15][main.log]:"i am spider man"
}
Channel
正如前文所述,golang坚持使用通信来实现共享内存,前面大篇幅文章介绍golang的并发原语goroutine以及相关的系统工作流,接下来就要讨论不同的goroutine如何进行通信,这就需要经过中间的核心结构体————Channel;
Channel的通信遵循FIFO原则:先从Channel读取或者发送的goroutine会优先收到数据或者得到发送数据的权利。稍早版本的Channel采用唤醒和重试机制作为读写原则,不遵循FIFO,如发送方写入数据,多个接收方会被唤醒并且读取数据,没有读取到的会重新休眠;反之亦然,接收方读取数据也会唤醒发送方,发送方尝试向缓冲区写入数据,若缓冲区满则陷入休眠。
悲观锁与乐观锁
正如我们开篇所说,golang的CAS本质是用单个goroutine去读写共享内存,其余goroutine唯一要做的就是排队,数据竞争从共享内存转移到通信上来,如何保证通信的原子性,和这里Channel通信的并发保护密切相关。
锁是并发控制的技术,对Java er而言很熟悉了,常常区分成悲观锁和乐观锁:
悲观锁:总是假设最坏的情况,认为每次拿数据时别人都会修改,因此每次拿数据总会上锁,直至使用完将其释放给其他线程使用;
乐观锁:总是假设最好的情况,认为拿数据时别人不会修改,拿数据时不上锁,但是在更新时会采取类似版本号法、CAS无锁算法等判断别人有没有更新这个数据;
CAS算法判断内存的值和预期值是否相等,若相等则替换为新值,但CAS存在ABA问题,即内存值与预期值相等不能说明内存值一直没有被篡改,有可能刚刚好改回来而已,因此可以引入版本号,CAS校验时不仅验证内存值是否等于预期值,还可以验证地址值、版本号等等,通过多重CAS手段来实现乐观锁。
Channel数据结构实现
近年社区多次提出无锁的数据结构实现FIFO队列来实现Channel,但多核测试仍然需要改进,故目前的Channel还是基于互斥锁实现的有锁队列,底层对象为runtime.hchan:
1
2
3
4
5
6
7
8
9
10
11
12
13
14type hchan struct {
qcount uint //队列中元素的个数
dataqsiz uint //环形队列size
buf unsafe.Pointer //Channel缓冲区数据指针
elemsize uint16 //元素大小
closed uint32 //持锁关闭,阻塞的recvq会收到零值,阻塞的sendq会收到panic
elemtype *_type //元素类型
sendx uint //已发送元素在环形队列的位置
recvx uint //已接收元素在环形队列的位置
recvq waitq //接收者的等待队列,存储缓冲区不足而阻塞的goroutine
sendq waitq //发送者的等待队列,存储缓冲区不足而阻塞的goroutine
lock mutex
}waitq类型,当channel收不到或者发不出去需要阻塞goroutine时,会将这些goroutine包装成一个sudog节点挂到对应的waitq上,然后gopark挂起,等待条件满足(对端数据到来、close等)再取出并且goready唤醒;
waitq本质是一个链表,分别指向整个阻塞链表的头尾指针:
1
2
3
4type waitq struct {
first *sudog
last *sudog
}waitq的入队和出队都受lock的保护,保证并发安全和队列的一致性。
阻塞的gotoutine被包装成sudog(版本不同结构会略有差异):
1
2
3
4
5
6
7
8
9
10type sudog struct {
g *g // 被阻塞/等待的 goroutine
next *sudog // waitq 链表指针
prev *sudog // 某些版本/场景(如 select)用于中间删除
elem unsafe.Pointer // 数据拷贝用的地址(非常关键)
c *hchan // 所属 channel
isSelect bool // 是否来自 select
success bool // 是否成功完成通信(select/close 等需要)
// ... 还有一些调试/时间戳/票据等字段
}elem,指向发送方要发送数据的内存地址(通常位于goroutine的临时栈上),或者指向接收方用于存放接收数据的地址(也可能在临时栈上),当send和recv匹配成功,runtime会在持锁条件下直接memmove,将发送方的elem拷贝到接收方目标地址,对于存在缓冲区的,则从缓冲区或者向缓冲区拷贝。此处如果gopark阻塞,栈在匹配前都不会产生增长,go
runtime也使用一些标记保证此时临时栈的可靠性,故能直接作为目标内存地址被使用。
isSelect和success等标志位主要用于select情况的goroutine阻塞,此时sudog可能会被挂到不同的channel的waitq上,需要一个标志位来标记改goroutine是否被其他channel成功唤醒;
再者,sudog也被设计成runtime中的私有缓存池,会优先从P对应的空闲sudog list中获取,再绑定对应阻塞的goroutine
Channel类型
Channel是一种引用类型,表示一种在goroutine间传递某种数据类型的通道,其空值表示为nil,同slice、map等引用类型相似,需要使用make来分配空间和内存初始化:
主要格式是: 1
2
3var 变量名 chan 数据类型
变量名 := make(chan 数据类型,[缓冲区容量])
此处的数据类型可以几乎是一切数据类型,如map、slice、自定义结构体、接口、函数或者嵌套的chan等:
1
2
3
4
5
6
7var ch_int chan int
fmt.Println(ch_int == nil) //true
ch_int = make(chan int)
fmt.Println(ch_int == nil) //false
ch_bool := make(chan []int, 20) //false
fmt.Println(ch_bool == nil)
区分len(chan)和cap(chan)
上述使用make为缓冲区分配固定容量,如果省略make的缓冲区不指定大小或者指定0,代表该通道不使用缓冲区,其行为和使用缓冲区有鲜明的区别:
- 无缓冲区:发送和接收都必须有空闲的goroutine,否则会阻塞,如果缺少定义(如单独定义接收方或者发送方),会运行时panic死锁,如:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19package main
import (
"fmt"
"time"
)
func main() {
ch_send := make(chan int)
ch_send <- 10 //fatal error: all goroutines are asleep - deadlock!
fmt.Println(len(ch_send), cap(ch_send))
go func() { //不会走到这里,send发送时ch_recv还没来得及接收
ch_recv := <-ch_send
fmt.Println("recv:", ch_recv)
}()
time.Sleep(time.Millisecond * 10)
} - 带缓冲区:等待队列长度小于容量,发送和接收都不会阻塞,接收会返回队头元素,若超出容量,则仍然会阻塞新到来的goroutine信息;
len返回缓冲区中正在等待被发送和被接收的元素个数,对应于hchan结构的qcount字段,
cap返回的是缓冲区的容量,对应于hchan结构的dataqsiz。
Channel发送数据
1 | var i int |
正如上述所说:
N==0为无缓冲区发送:runtime通过sendDirect函数将要发送的数据i拷贝到ch_send的内存地址上,调用goready将对应接收数据的goroutine标记为grunnable并把goroutine放在对应的P的runnext槽等待执行;N!=0为缓冲区发送:runtime将要发送的数据拷贝到缓冲区下一个位置,增加hchan.sendx和qcount计数器,因为hchan.buf是一个循环数组,当容量满sendx==dataqsiz,runtime通过acquireSudog获取空闲sudog资源,绑定到goroutine并且设置select相关标记(select可以在Channel满时也实现非阻塞),然后标记goroutine waiting标记位代表g正在等待sudog就绪,直到被调度器唤醒、释放sudog资源。
Channel接收数据
1 | var i int |
接收数据前首先会检查channel的状态:
若channel为
nil:runtime调用gopark让出处理器的使用权;若channel关闭且缓冲区不存在数据:接收chan的数据值(ep指针)会被清除且立刻返回,如上述的i会被置空,变为
0、nil、""或者空结构体等,如果仅关闭但存在数据,仍然会进入以下正常接收的阶段。
如果channel状态正常,则进入接收阶段,也区分几种情况:
若channel无缓冲区接收:从发送方goroutine的栈空间(上文已经说了,此时阻塞栈空间是安全使用的)或者sendq中的elem中(发送方goroutine已经阻塞且进入sudog等待)拷贝元素到目标地址上(i的地址);
若channel为缓冲区接收且缓冲区存在数据:通过
typedmemmove直接将recvx指向的缓冲区元素拷贝到目标地址i上,递增recvx,qcount计数器减1,如果recvx==dataqsiz,则回到循环数组的起点,重新赋值recvx=0;同时,如果sendq存在等待的sudog,会将队头元素拷贝到buf[recvx]位置并且调用goready将P的runnext设置成队头sudog的g,在下次调度时发送方会被唤醒;
Channel关闭管道
channel通过close函数关闭通信管道,关闭前同样先检查两个状态:若channel已经关闭或者为nil channel,close会抛出panic:
1
2
3
4
5
6
7
8
9
10
11
12
13package main
import "fmt"
func main() {
var ch chan int
close(ch) //panic: close of nil channel
ch1 := make(chan int, 0)
fmt.Println(ch1 == nil)
close(ch1) //ok
close(ch1) //panic: close of closed channel
}sendq和recvq中的sudog的goroutine收集到临时唤醒链表glist中,释放channel锁(因为唤醒会改变goroutine标志位,防止死锁)后调用runtime.goready唤醒每个阻塞的协程,协程会重新被某个P
runtime调度或者加入全局runq,因为通道关闭,来自sendq释放的协程会收到panic,来自recvq的会返回零值和ok=false的结果。
切记:当通道需要关闭时(存在未来都没有数据的情况),在通道接收完或者发送完元素后必须要close通道,否则runtime可能会检测到协程死锁而panic。
Channel Demo
通过通道发送、转发和接收的例子只需要简单的写法: 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33package main
import "fmt"
func main() {
ch1 := make(chan int, 0)
ch2 := make(chan int, 0)
go func() {
for i := range 5 {
ch1 <- i
fmt.Println("ch1 send:", i)
}
close(ch1)
}()
go func() {
for {
i, ok := <-ch1
if !ok {
break
}
i2 := i * i
ch2 <- i2
fmt.Println("ch2 tranfer:", i2)
}
close(ch2)
}()
for i := range ch2 {
fmt.Println("main recv: ", i)
}
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15ch2 tranfer: 0
main recv: 0
ch1 send: 0
ch1 send: 1
ch2 tranfer: 1
ch1 send: 2
main recv: 1
main recv: 4
ch2 tranfer: 4
ch2 tranfer: 9
ch1 send: 3
ch1 send: 4
main recv: 9
main recv: 16
ch2 tranfer: 16
select
对于需要同时响应多个通道的接收和发送操作,常规的写法比较难实现,因为golang难以判断发送和接收的具体阻塞状态,也不知道数据何时能就绪,因此golang提供了select,能够在多个通信channel中实现原子化的选择:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25package main
import "fmt"
func main() {
ch := make(chan int, 1)
ch1 := make(chan int, 1)
ch <- 1
ch1 <- 2 //有缓冲区,非阻塞
for i := range 2 {
_ = i
select {
case v := <-ch:
fmt.Println("ch recv:", v)
case v := <-ch1:
fmt.Println("ch1 recv:", v)
}
}
}
//输出:
//ch recv: 1
//ch1 recv: 2
select随机性和default
为了防止线程饿死,多个case在等待同一个通道数据时,select会随机挑选一个case执行:
1
2
3
4
5
6
7
8
9ch := make(chan int, 1)
ch <- 1 //有缓冲区,非阻塞
select {
case v := <-ch:
fmt.Println("ch recv:", v)
case v := <-ch:
fmt.Println("ch1 recv:", v)
}
如果channel没有缓冲区,那么主协程就会卡死在发送ch <- 1,就算另起协程也不能保证发送端不会先阻塞;同理,如果没有发送,select也会卡死出现死锁panic,但是如果存在default,就会执行default分支而不至于死锁:
1
2
3
4
5
6
7
8
9
10ch := make(chan int, 1)
select {
case v := <-ch:
fmt.Println("ch recv:", v)
case v := <-ch:
fmt.Println("ch1 recv:", v)
default:
fmt.Println("NO DATA") //输出NO DATA
}
select简单的应用
select以上的特性可以产生一些简单应用,以下。
检查通道是否已经满
1 | ch := make(chan int, 1) |
实现超时机制
假设不使用default,select可以通过超时协程来实现超时监听,当某段时间超时后自动退出:
1
2
3
4
5
6
7
8
9
10
11
12
13timeout := make(chan bool, 1)
go func() {
time.Sleep(time.Millisecond * 10)
timeout <- true
}()
ch := make(chan int)
select {
case v := <-ch:
fmt.Println("ch recv", v)
case <-timeout:
fmt.Println("timeout") //输出timeout
}time.After:func After(d time.Duration) <-chan time.Time,
在时长d后会自动向定时器只读通道发送time.Time触发超时:
1
2
3
4
5
6
7
8
9
10
11
12
13
14ch := make(chan bool, 1)
go func() {
time.Sleep(time.Millisecond * 200)
ch <- true
fmt.Println("Done")
}()
select {
case <-ch:
fmt.Println("task finish")
case <-time.After(time.Millisecond * 300):
fmt.Println("timeout")
}time.After都会新构造一个定时器,而且不会GC,因此在循环中使用select + time.After内存会累积,故应该使用专门的可复用定时器进行超时;
参考链接: